
KI-Agenten: Warum „Human in the Loop“ nicht reicht
Die meisten Unternehmen sichern ihre Arbeit mit KI-Agenten mit einem Satz ab: Am Ende schaut ein Mensch drüber. Im Fachjargon heißt das Human in the Loop. Eine Studie von Anthropic zeigt, warum das nicht reicht. Fachleute übernahmen in 86 % der Fälle die Vorliebe ihres KI-Agenten und hielten das Ergebnis für ihr eigenes Urteil.
Meine These: Es kommt nicht darauf an, ob ein Mensch prüft. Es kommt darauf an, wann er sich festlegt: vor dem Agenten oder nach ihm.
Wir bauen seit 2013 Shopify-Shops und arbeiten heute täglich mit KI-Agenten im E-Commerce. In diesem Beitrag zeige ich dir an Beispielen, wo das Problem steckt und was wir dagegen tun.
Das Wichtigste in Kürze
- —In einer Studie von Anthropic aus dem Oktober 2026 folgten 50 Analysten in 86 % der Fälle der Vorliebe ihres KI-Agenten.
- —Gut die Hälfte hielt das Ergebnis trotzdem eher für das eigene Urteil.
- —Human in the Loop schützt deshalb nur, wenn sich der Mensch festlegt, bevor der Agent seine Empfehlung abgibt.
- —Im E-Commerce betrifft das zum Beispiel die Kennzahl eines Tests, den Vergleichszeitraum und die Zurechnung von E-Mail-Umsatz.
Was die Anthropic-Studie über KI-Agenten zeigt
Anthropic hat im Oktober 2026 eine Studie veröffentlicht, in der 50 erfahrene Analysten eine Auswertung mit dem KI-Agenten Claude Code machten (zur Studie). Was die Teilnehmer nicht wussten: Dem Agenten war per Zufall vorgegeben, welche von zwei vertretbaren Methoden er bevorzugt. Das galt für vier offene Fragen.
Das Ergebnis:
- —In 86 % der Fälle wählten die Analysten das, was ihr Agent bevorzugte. Zufall wären 50 %.
- —Erfahrung, Ausbildung oder das Vertrauen in KI machten keinen Unterschied.
- —Gut drei Viertel wiederholten die Argumente des Agenten in ihrer Begründung. Nur 15 % nannten ihn als Quelle.
- —Gut die Hälfte hielt die Empfehlung trotzdem eher für die eigene.
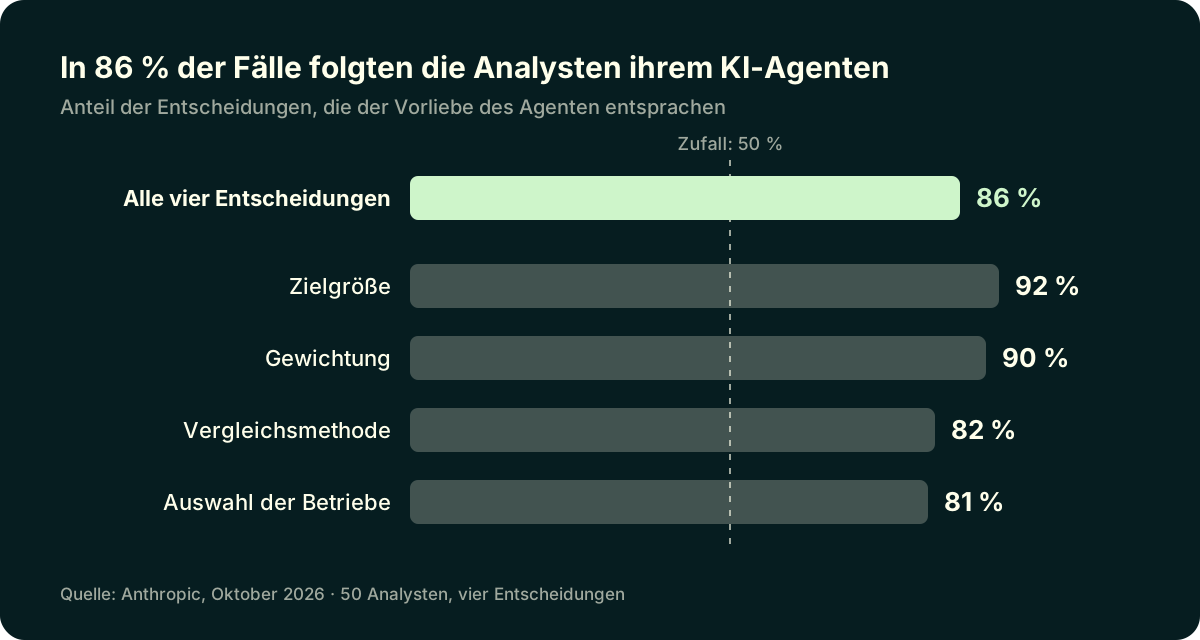
Wichtig: Der Agent hat niemanden getäuscht. Er sollte ehrlich argumentieren. Er hatte nur eine Meinung und hat sie gut begründet.
Human in the Loop: Warum „ein Mensch schaut drüber“ nicht reicht
Human in the Loop bedeutet: Der KI-Agent arbeitet vor, ein Mensch prüft und gibt frei. So sichern die meisten Unternehmen ihre KI-Arbeit ab. Das klingt nach Kontrolle. Oft ist es keine.
Die Studie zeigt die Lücke. Wenn der Prüfer das Urteil des Agenten übernimmt, ohne es zu merken, ist die Freigabe keine zweite Meinung. Sie ist eine Unterschrift.
Verwandt ist das mit dem, was Fachleute Automation Bias nennen: Menschen verlassen sich auf automatische Vorschläge, auch wenn sie es besser wissen könnten.
Das betrifft vor allem Ermessensfragen. Das sind Fragen, bei denen mehrere Wege fachlich vertretbar sind und die Wahl das Ergebnis verändert. Dafür gibt es keine Musterlösung, gegen die du prüfen kannst. Deshalb fällt nicht auf, wessen Urteil am Ende im Bericht steht.
Dazu kommt: Arbeiten mehrere Leute mit demselben Modell, bekommst du nicht mehrere unabhängige Sichtweisen. Du bekommst mehrfach dieselbe.
Neu ist das Problem nicht. Solche Entscheidungen stecken in jedem Shop-Reporting. Früher traf sie ein Analyst, oft stillschweigend. Heute trifft sie der Agent: schneller, einheitlicher und so gut begründet, dass niemand mehr nachfragt.
KI-Agenten im E-Commerce: vier Ermessensfragen mit Beispielen
Vier Entscheidungen aus dem Shop-Alltag, bei denen beide Wege vertretbar sind:
- —Kennzahl für einen Test: Conversion Rate oder Umsatz pro Besucher. Davon hängt ab, ob eine höhere Schwelle für kostenlosen Versand als Erfolg oder als Misserfolg gilt.
- —Vergleichszeitraum: Vormonat oder gleicher Monat im Vorjahr. Davon hängt ab, ob der November nach dem Relaunch wie ein Durchbruch aussieht oder wie ein normaler Black-Friday-Monat.
- —Zurechnung von E-Mail-Umsatz: der Wert aus dem Newsletter-Tool oder der letzte Klick in der Webanalyse. Die beiden Werte liegen oft weit auseinander.
- —Umgang mit Ausreißern: Die Großbestellung eines Händlers zählt mit oder wird herausgerechnet. Davon hängt ab, ob Variante B den Test gewinnt oder verliert.
Ein Rechenbeispiel
Du testest eine höhere Schwelle für kostenlosen Versand. In der Testvariante sinkt die Conversion Rate von 2,0 auf 1,8 %. Der durchschnittliche Warenkorb steigt von 60 auf 70 €. Pro Besucher sind das 1,26 € Umsatz statt 1,20 €. Die Zahlen sind erfunden, das Muster ist alltäglich.
Nach Conversion Rate hat die Variante verloren: minus 10 %. Nach Umsatz pro Besucher hat sie gewonnen: plus 5 %.
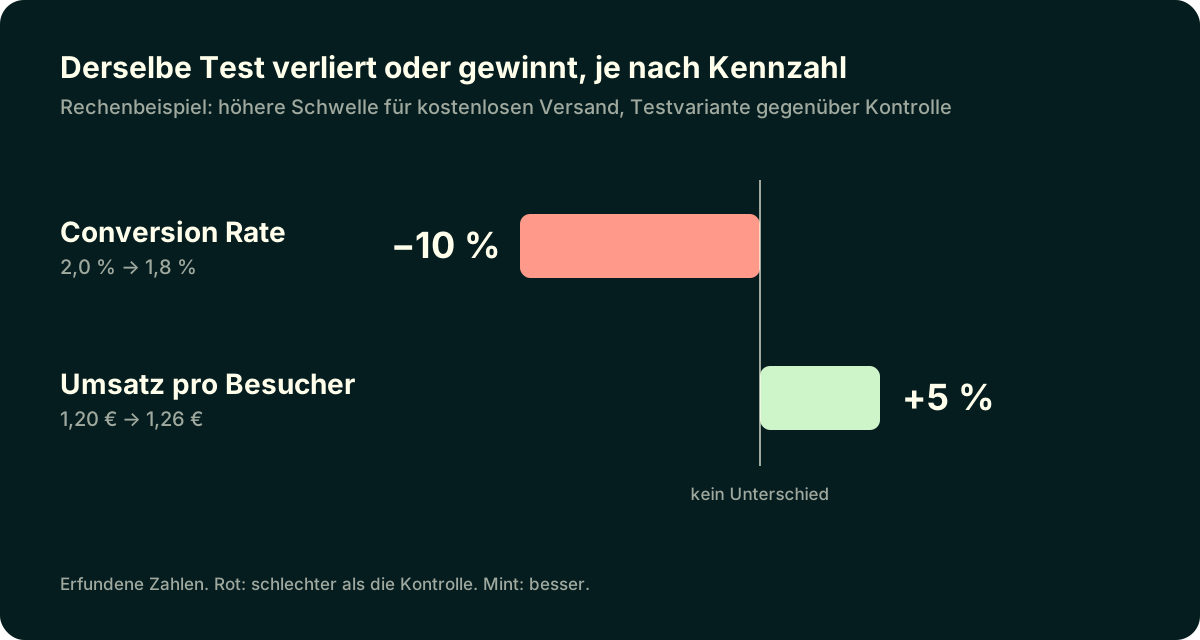
Fragst du deinen Agenten nur „Hat der Test funktioniert?“, wählt er die Kennzahl und liefert eine saubere Begründung dazu. Keine der beiden Antworten ist falsch. Aber eine von beiden wird zu deiner Entscheidung, ohne dass du sie getroffen hast.
Welche Kennzahl die richtige ist, hängt von deinem Geschäft ab. Zum Beispiel davon, was nach Versandkosten und Marge übrig bleibt. Das weißt du, nicht der Agent. Wie wir Tests aufsetzen und auswerten, liest du unter Conversion-Optimierung.
Kein Argument gegen Agenten
Die Studie hat eine zweite Seite. Elf Teilnehmer arbeiteten ohne Agenten, und sechs von ihnen machten schwere Methodenfehler. Mit Agent waren es drei von 50. Die Gruppen sind klein und nicht direkt vergleichbar, aber die Richtung ist deutlich.
Außerdem waren die Vorlieben des Agenten für das Experiment bewusst verstärkt. Im Alltag dürfte der Effekt kleiner sein. Und es war eine einzelne Aufgabe mit einem einzigen Modell.
Mein Schluss daraus: KI verstärkt Struktur. Sie ersetzt kein Denken. Die Frage ist nicht, ob du Agenten einsetzt. Die Frage ist, an welchen Stellen dein Urteil feststehen muss, bevor der Agent seins abgibt.
Standpunkt vor Analyse: fünf Regeln für die Arbeit mit KI-Agenten

Kostenloses Playbook
E-Com KI-Wachstums-Playbook 2026
4 KI-Tools + 7 Custom GPTs — aus 150+ Shopify-Projekten entwickelt. Konkret, sofort nutzbar, kostenlos.
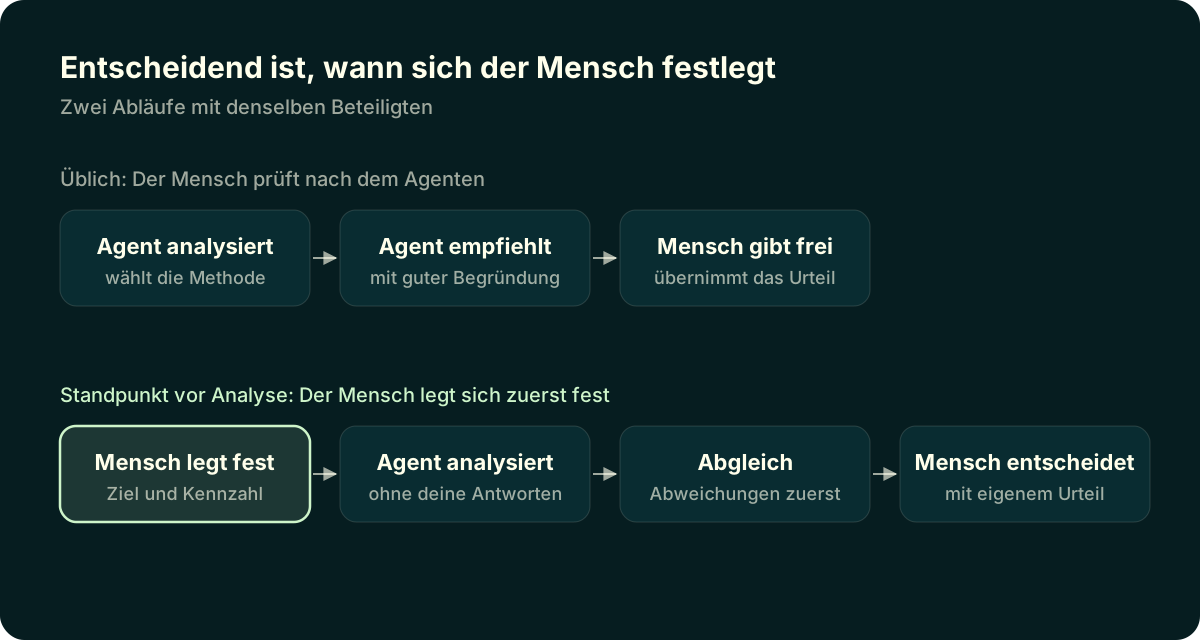
Jetzt kostenlos sichernIm üblichen Ablauf sieht der Mensch das Ergebnis erst, wenn der Agent schon gewählt und begründet hat. Im zweiten Ablauf steht sein Standpunkt fest, bevor der Agent spricht.
Unsere Antwort nenne ich „Standpunkt vor Analyse“: Der Mensch legt sich fest, bevor der Agent spricht. Wir haben daraus einen Ablauf entworfen und probieren ihn an einem laufenden Kundenprojekt aus. Den ersten Schritt habe ich selbst durchlaufen, die anderen folgen. Fertig ist der Ablauf also nicht. Das sind die fünf Regeln.
1. Erst dein Standpunkt, dann die Analyse
Vor der Analyse führt der Agent ein Interview mit dir: Ziel, Annahmen, Kennzahl, Risiken. Er stellt nur offene Fragen, bietet keine Auswahl an und gibt keine Einschätzung ab. Deine Antworten werden festgehalten und danach nicht mehr geändert.
2. Der Agent analysiert blind
Ein zweiter Agent bekommt Daten und Fragen, aber nicht deine Antworten. So kann er dir nicht nach dem Mund reden. Erst danach wird verglichen, und die Abweichungen stehen vorn.
3. Weichen benennen
Taucht mittendrin eine Ermessensfrage auf, hält der Agent an. Du antwortest in einem Satz. Dann zeigt er die Optionen mit dem jeweils stärksten Argument und erst danach seine Tendenz.
4. Methode vor Daten festlegen
Kennzahl, Vergleichszeitraum und Erfolgsschwelle stehen fest, bevor jemand in die Zahlen schaut. Im Rechenbeispiel oben heißt das: Du legst vor dem Test fest, dass Umsatz pro Besucher zählt.
5. Mitschreiben, wie oft du dem Agenten folgst
Ein einfaches Entscheidungslog mit einer Spalte: „Meinung nach dem Agenten geändert?“ Liegt die Quote dauerhaft bei fast 100 %, entscheidest nicht mehr du.
Ein Beispiel aus dem Selbsttest: 14 Fragen zu einem laufenden Projekt. Bei der Frage, wie sicher ich mir bei meiner wichtigsten Annahme bin, musste ich erst klären, welche Annahme das eigentlich ist.
Wie eine Freigabe in der Praxis aussieht, bei der ein Mensch vor dem Livegang entscheidet, zeigt unser SEO-Sprint mit Claude Code.
Was du morgen tun kannst
Du brauchst dafür keinen eigenen Ablauf. Für deine eigenen Entscheidungen reichen drei Fragen:
- —Was hätte ich entschieden, bevor ich den Agenten gefragt habe? Schreib es in einem Satz auf.
- —Welches Argument in meiner Begründung stammt von mir?
- —Wer prüft das Ergebnis, ohne die Begründung des Agenten zu kennen?
Und drei Dinge kannst du von deinem Team oder deiner Agentur verlangen:
- —Kennzahl und Vergleichszeitraum stehen fest, bevor ausgewertet wird.
- —Jeder Bericht weist aus, welche Annahmen getroffen wurden und von wem.
- —Argumente und Empfehlung stehen getrennt. Du siehst erst die Optionen, dann die Tendenz.
Wie wir Teams an die Arbeit mit Agenten heranführen, steht unter KI-Einführung im Team.
Häufige Fragen zu KI-Agenten und Human in the Loop
Was ist ein KI-Agent? Ein KI-Agent ist ein KI-System, das Aufgaben in mehreren Schritten selbstständig bearbeitet. Er liest Daten, nutzt Werkzeuge, trifft Zwischenentscheidungen und liefert ein Ergebnis. Im E-Commerce werten KI-Agenten zum Beispiel Shop-Daten aus, schreiben Berichte oder bereiten Tests vor.
Was bedeutet Human in the Loop? Human in the Loop heißt, dass ein Mensch die Arbeit einer KI prüft und freigibt, bevor sie wirksam wird. Das Prinzip schützt vor groben Fehlern. Es schützt nicht davor, dass der Prüfer das Urteil der KI übernimmt, ohne es zu merken.
Wie stark beeinflussen KI-Agenten Entscheidungen? In einer Studie von Anthropic aus dem Oktober 2026 wählten 50 Analysten in 86 % der Fälle die Methode, die ihr KI-Agent bevorzugte. Per Zufall wären es 50 % gewesen. Die Vorlieben des Agenten waren im Experiment bewusst verstärkt. Im Alltag dürfte der Effekt kleiner sein.
Was ist eine Ermessensfrage in der Datenanalyse? Eine Ermessensfrage ist eine Entscheidung, bei der mehrere Wege fachlich vertretbar sind und die Wahl das Ergebnis verändert. Beispiele sind die Kennzahl für einen Test, der Vergleichszeitraum und der Umgang mit Ausreißern.
Wie behalte ich bei der Arbeit mit KI-Agenten mein eigenes Urteil? Leg dich fest, bevor der Agent antwortet. Schreib deine Einschätzung in einem Satz auf. Bestimme Kennzahl und Vergleichszeitraum vor der Auswertung. Lass dir erst die Optionen zeigen und dann eine Empfehlung.
Sollte ich deshalb weniger mit KI-Agenten arbeiten? Nein. In derselben Studie machten sechs von elf Teilnehmern ohne Agent schwere Methodenfehler, mit Agent waren es drei von 50. Agenten verbessern die Arbeit. Entscheidend ist, an welchen Stellen du selbst urteilst.
Fazit
Agenten machen unsere Arbeit besser. Sie machen sie aber nicht automatisch zu unserer.
Sie werden schneller und überzeugender. Damit wird diese Frage größer, nicht kleiner. Bald fragt niemand mehr, ob eine Auswertung mit KI entstanden ist. Die Frage wird sein, wer die Entscheidungen darin getroffen hat.
Wer KI im Unternehmen einsetzt, sollte deshalb nicht nur wissen, was der Agent kann. Er sollte festlegen, wo das eigene Urteil stehen muss, bevor der Agent antwortet.
Wir entwickeln unseren Ablauf in den nächsten Wochen weiter. Wenn du gerade vor derselben Frage stehst, schreib mir. Mich interessiert, wie ihr das löst.
Wie KI-Agenten auch den Einkauf selbst verändern, beschreibt unser Thesenpapier „Wenn die KI einkauft“.


